Jev:决策模型与 API 选型
Jev 是 TypeSafe AI 专门为分类、是非判断和评分训练的决策模型,输入业务状态和限定问题,直接返回结果及概率分布。
它适合“答案已经列好,但需要理解语言才能选择”的任务,例如工单分流、请求路由和内容筛查。写回复、计算金额、决定退款资格,不应直接交给它。是否值得接入,要用真实业务数据与现有方案比较,不能只看演示速度。
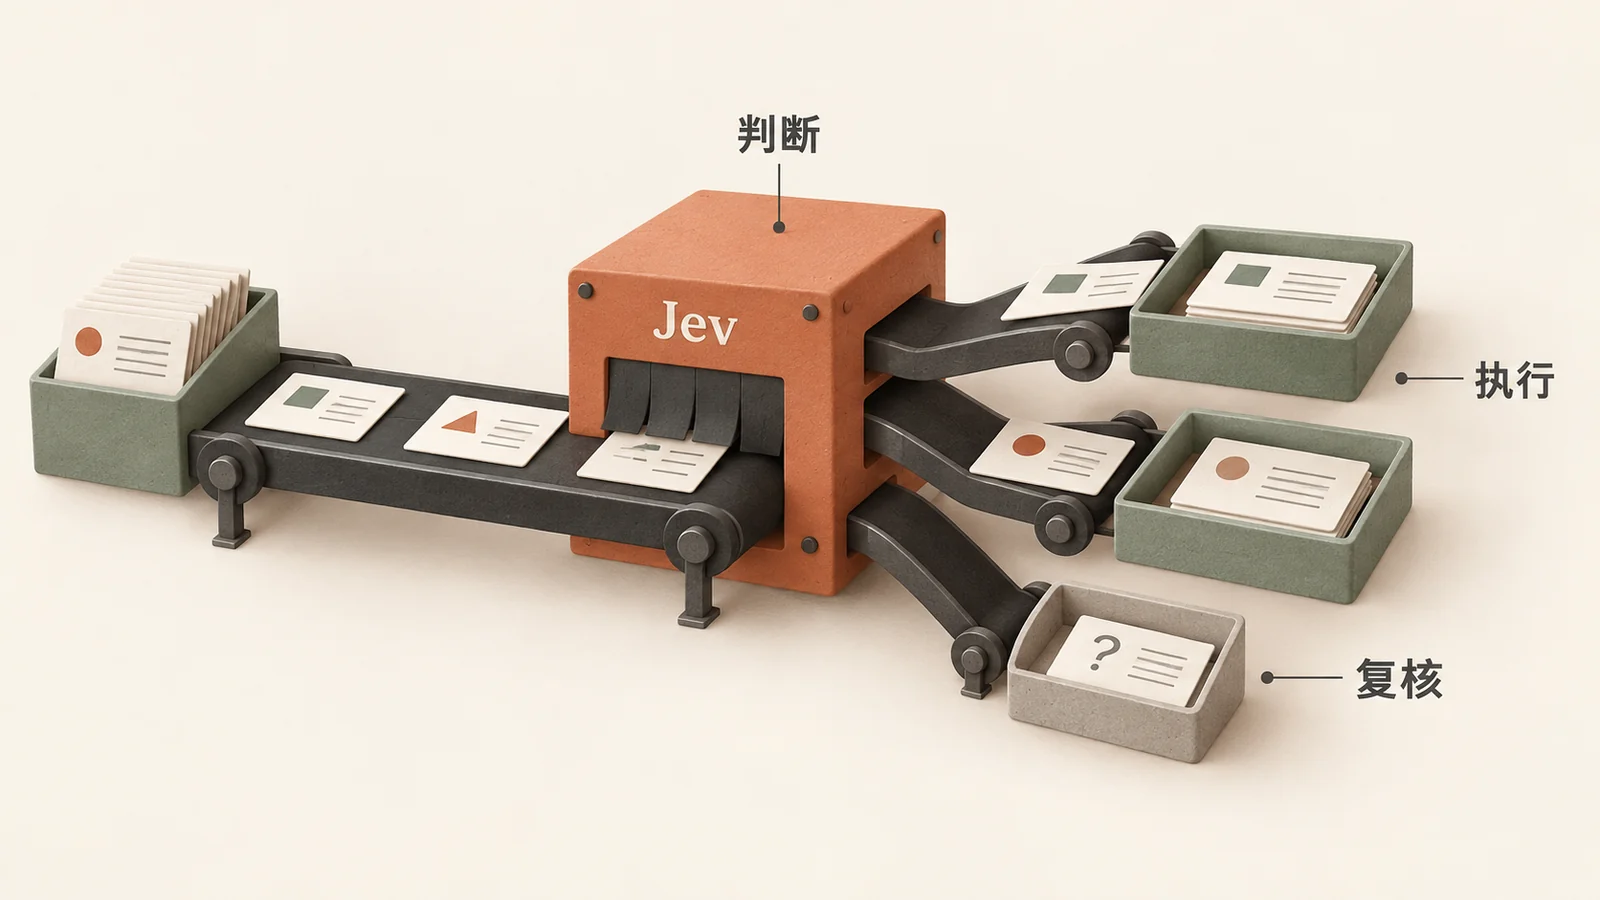
用一张工单看懂 Jev
Section titled “用一张工单看懂 Jev”假设客服收到:“同一份订阅被扣了两次,请退掉重复的那笔。”可以拆成三类问题:
- 分类(
choice):交给账单、技术、账户还是其他团队?返回选中的类别及各类别概率。 - 是非判断(
noul):用户是否明确要求退款?返回“是”的概率。 - 评分(
score):按普通咨询、部分功能受阻、核心业务中断等预设等级,评估紧急程度。返回各等级概率及加权评分。API 定义
程序可以据此派单,但“用户要求退款”不证明重复扣款属实,仍要查交易记录。多个独立问题可以一起问;需要先查订单、再判断资格的流程,必须由程序分步组织。
普通 LLM 只输出 A、B、C,也能做分类。Jev 的区别在于专门训练决策及其概率,TypeSafe 称这种训练为 RLCD。它还声明采用了新的模型架构,因此不能把 Jev 等同于“普通 LLM 少输出几个字”。官方发布说明
训练目标之一是概率校准:大量被预测为 90% 概率的判断,实际应约有 90% 成立。这让程序有依据选择自动处理或复核,但不保证某一次判断正确;返回的 confidence 也不是另一次测出的正确率,而是从概率分布计算的汇总值。训练目标、置信度定义
读取 Qwen 等普通模型的下一 token 分数,也能得到固定选项的概率;token 是模型处理文字的单位。但这种做法没有复制 Jev 的训练。若原方案已经只生成一个 token 并返回候选分数,计算优势可能很小;省掉解释文字,也不会省掉读取长输入的计算。SGLang 评分接口
哪些场景值得接入
Section titled “哪些场景值得接入”优先考虑输出范围有限、需要理解语言、调用频繁、结果能检查的任务。
| 场景 | 适合交给模型的判断 |
|---|---|
| 客服分流 | 属于哪个团队,是否需要升级处理 |
| Agent 路由 | 是普通问答、复杂任务、设备控制,还是需要澄清 |
| 内容筛查 | 是正常讨论、广告,还是需要复核的内容 |
| RAG 与记忆 | 材料是否相关,候选事实是否值得保留 |
| Agent 评测 | 回复是否有证据支持,是否完成指定目标 |
例如家庭助手收到“把客厅灯调到 30%”,决策模型可以判断这是设备控制;设备 ID 和亮度参数仍要另行提取,执行交给已有 Skill 与 HA 脚本。模型判断一个请求属于哪类,不等于完成了这项任务。
哪些场景不合适
Section titled “哪些场景不合适”以下是不适合直接交给决策模型完成的任务,其中一些可以拆出较小的判断交给它。
| 任务 | 为什么不适合,应该怎么做 |
|---|---|
| 写文章、生成代码、提取任意字段 | 答案不是预设选项。用生成模型或解析器;已有候选值时,再让决策模型选择。 |
| 算金额、比较日期、执行确定规则 | 需要精确结果。直接用代码、数据库和规则引擎。 |
| 多步调查、复杂推理、长期规划 | 一次分类不足以完成。用工具查询、推理模型和分步流程,必要时把局部判断拆出来。 |
| 依据缺失、标准含糊 | 换模型不能补齐事实。先查询数据、请求澄清或明确标准,不强迫它猜。 |
| 直接决定权限、扣款或退款 | 概率不能代替授权和业务校验。模型可识别意图,最终操作由程序按规则执行。 |
Jev 1.13 官方明确列出了数字处理、复杂间接推理、无关长上下文、对抗性内容和选项顺序等限制。专用训练并没有消除这些问题。已知限制
另外,Jev 1.13 只接收文本,英文是主要训练语言。图片、音频任务要先转换输入或选择其他模型;中文业务必须单独评测。模型信息
低频任务或已有可靠规则时,也不必为了“决策模型”新增服务。多一次请求就多了网络延迟和故障点;如果分类之后大部分请求仍要调用原来的模型,总成本可能反而上升。
国内外 API 怎么选
Section titled “国内外 API 怎么选”以下按 2026-10-10 的官方文档整理。能调用不等于满足生产要求,上线前仍要确认账户可用性、容量、服务承诺和数据处理条款。
| 服务 | 模型与关键限制 |
|---|---|
| 阿里云百炼 | decision-model-preview,System One 接口,北京、新加坡地域;仍是 Preview。API |
| TypeSafe 原厂 | jev-1.13.0 / jev-latest,/v1/systemone 接口;当前只接收文本,中文需评测。模型页 |
| Vercel AI Gateway | typesafe-ai/jev,转接的仍是 TypeSafe Jev,适合已有 Gateway 接入的项目。模型页 |
| Cloudflare Workers AI | @cf/cloudflare/clef、@cf/cloudflare/clef-flash,是 Jev 之外的决策模型,支持图片输入。Clef、Clef-flash |
| OpenAI Decisions API | gpt-6-luna,/v1/decisions 接口,支持文本和图片;当前为 Public Beta,格式与 System One 不同。官方说明 |
国内后端可以先评测百炼,海外项目可以先评测已接入平台的服务。需要图片判断时排除目前的 Jev 文本接口;已有小模型分类方案时,把它保留作对照,不预设专用决策模型一定更好。
百炼用 state 传业务数据、questions 传问题,不能只给 chat/completions 换个模型名。其 Preview 当前不支持上下文缓存和模型调优,限时免费也不能作为长期成本依据。模型限制
生产后端应使用适合该用途的模型服务 Key 和工作空间,不能把编程工具的 Token Plan 套餐 Key 直接搬过来;套餐有自己的使用范围限制。Token Plan 使用范围
动作很多时,怎样缩小选项
Section titled “动作很多时,怎样缩小选项”把允许的动作列成 choice 选项,模型就能选择下一步。Jev 与百炼每个 choice 最多 255 项,包含“其他 / 无法判断”;这是单个问题的上限,不是整个系统的动作总量,也不是准确率保证。Jev API、百炼 API
选项增多可能增加混淆,尤其是名称相似、描述含糊或夹杂无关信息时,但不能断言准确率必然随数量下降。下面的官方实践也没有给出通用最佳数量。候选很多时,可先以 5–20 项的短名单做试验;这是工程起点,不是官方推荐值,边界清楚的更大候选集也应保留作对照。
- 先筛候选:用权限、设备能力和当前状态排除不可用动作,必要时再检索相关动作。设备 ID、亮度等参数另行处理,不枚举“每个设备 × 每种动作 × 每个参数值”的所有组合。
- 有自然分类时分层:例如先选“灯具 / 空调 / 窗帘”,再选该类的具体动作。上层选错会排除正确动作;模糊时保留几条分支继续判断。TypeSafe 的官方示例采用保留多条路径的 Beam Search(束搜索),而非每层只留下一个答案。分层分类示例
- 超过上限时分批复选:每批保留“不在本批”的出口和少量候选,再把入围的动作放进同一个
choice比较,直到符合上限。不同批次的概率各自归一化,不能直接拿它们的最高概率排出全局赢家;过早淘汰的正确动作也无法靠后续步骤找回。
TypeSafe 用 jev-1.12 从 182 个 Skills 粗排,再读取前三名的详细内容复选,并允许全部不适用。这是可借鉴的两阶段案例,不是“182 项都能准确选择”的保证。Skill 选择示例
Anthropic 的工具检索示例每次加载 3–5 个相关工具,也说明了“先找到相关候选,再详细判断”的做法。但工具调用与 Jev 分类不是同一项任务,不能把 3–5 当作 Jev 的最佳选项数。官方工程实践
怎样验证,再逐步上线
Section titled “怎样验证,再逐步上线”先选一个独立任务,例如工单分流。只传相关事实,写清各类别边界,并加入“其他 / 信息不足”的选项,为它安排澄清或复核流程。
用同一批已标注的业务样本比较现有方案和候选 API,至少检查:
- 效果:各类别误判、自动接受结果的正确率,以及自动处理比例。缩小候选后,先检查正确动作是否仍在候选中;中文、模糊输入、范围外请求和对抗性内容都要覆盖,并打乱选项顺序重测。
- 概率:检查高分结果是否真的更可靠,用一批数据调阈值、另一批验证。供应商字段定义不同,阈值不能直接照搬;候选集变更后也要重测。
- 代价:看包含网络、分层或分批请求、重试和回退的整体延迟,以及每次有效处理的总成本,而不只看模型单价。
先只记录模型判断,不改变原有处理;确认效果以后,再逐步接管分流。低把握结果和接口超时进入澄清、通用队列或复核流程,不默认执行动作。保存判断标准、模型版本、概率和最终结果,更新时重测;调过阈值的 Jev 服务宜固定版本,而非直接跟随 jev-latest。