Agent 工具与运行环境:权限、幂等、沙箱与决策模型
生产 Tool 是受权限和状态保护的业务接口。 模型只提出工具名和参数,执行代码必须重新检查身份、资源归属、审批、幂等和业务状态。Schema 合法只说明参数形状正确,不说明这次操作有权发生,也不说明业务结果正确。
运行环境则回答另一个问题:工具在哪里执行。操作本机文件就保留本地执行,服务大量用户就用云端服务,控制现场设备就把最后的状态核对留在现场,运行生成代码时再加沙箱。模型 API 在哪里,与 Agent 主程序在哪里,是两件事。
1. 工具契约先表达业务意图,再限制参数
Section titled “1. 工具契约先表达业务意图,再限制参数”不要给模型一个任意 run_sql,让它自己猜业务边界。把能力收窄成一件明确的事:
{ "name": "list_customer_orders", "description": "读取当前已授权客户最近的订单,只读。", "parameters": { "type": "object", "properties": { "customer_id": { "type": "string" }, "limit": { "type": "integer", "minimum": 1, "maximum": 20 } }, "required": ["customer_id", "limit"], "additionalProperties": false }}当前用户和租户由服务端认证结果提供。即使用户和模型都传了 customer_id,服务端仍要检查它是否属于当前授权范围,不能把这个字段当成授权凭证。
一份可执行契约至少要写清:
| 规则 | 具体要求 |
|---|---|
| 一件明确的业务事 | 动词加对象,说明适用与禁止条件,避免工具职责重叠 |
| 参数可校验 | 枚举优先于自由文本;数字、字符串和数组有上限;默认拒绝额外字段 |
| 身份另行绑定 | 用户、租户和 Agent 身份来自服务端,不接受模型自报 |
| 执行层再检查 | Schema 通过后,继续检查资源归属、业务状态和权限 |
“只创建草稿、不直接发送”也必须由实现保证,不能只写在 description 里。Anthropic Tool 设计
2. 授权绑定真实动作,不能只给一个 approved=true
Section titled “2. 授权绑定真实动作,不能只给一个 approved=true”可以按业务影响划分动作,而不是按工具名称划分:
| 等级示例 | 动作 | 执行方式 |
|---|---|---|
| R0 低敏只读 | 公开天气 | 可在任务内自动执行 |
| R1 私有只读 | 本人订单 | 检查身份和资源归属,结果脱敏 |
| R2 可逆写入 | 草稿、标签 | 明确范围,保存回执和撤销方式 |
| R3 难逆或高影响 | 发信、发布、删除、改权限 | 审批绑定真实目标、参数和有效期 |
| R4 金融或生产控制 | 付款、签约、生产 DDL | 强身份与审批;部分动作不开放给 Agent |
审批记录至少要能证明“谁在什么时间内批准了什么”:
{ "approval_id": "apr_123", "actor_id": "user_42", "tool": "send_email", "args_hash": "sha256:...", "expires_at": "2026-07-31T12:00:00Z"}收件人、金额、发布目标等关键参数改变后,旧审批不再覆盖新动作。执行时由策略组件再次核对审批和权限,而不是让 Agent 自己宣布已批准。
3. 写操作先处理重复调用与未知结果
Section titled “3. 写操作先处理重复调用与未知结果”以退款为例:第一次请求已经提交,响应却超时了。第二次调用不能直接再退一次,应使用同一业务操作的幂等键查询原结果。
POST /refundsIdempotency-Key: run_123:step_4服务端保存“幂等键 → 参数哈希 → 执行状态 → 最终结果”:
| 同一键再次到达 | 处理 |
|---|---|
| 参数相同且已完成 | 返回原结果 |
| 参数不同 | 拒绝复用 |
| 仍在执行 | 返回进行中 |
| 已失败 | 只在明确允许的策略下重试 |
幂等键要来自稳定的任务与步骤 ID,不能用每次重新生成的随机值,也不能简单把整段自然语言当键。
| 错误类别 | 下一步 |
|---|---|
| 参数非法 | 不盲目重试,可让模型修正一次 |
| 权限失败 | 拒绝,不向模型泄露内部细节 |
| 429 限流 | 按 Retry-After 有限退避 |
| 502 或短暂依赖失败 | 确认可重试,并限制次数和时间 |
| 已退款、版本冲突 | 重新读取状态再判断 |
| 超时且结果未知 | 按操作 ID 或幂等键查询,再决定是否重发 |
错误返回要结构化,并给排错用的关联 ID:
{ "ok": false, "error": { "code": "REFUND_ALREADY_EXISTS", "category": "business_conflict", "retryable": false, "safe_message": "该订单已有退款申请", "correlation_id": "corr_456" }}retryable: false 表示不能简单重发,不代表系统可以忽略这个错误。
4. 返回足够决策的信息,完整证据另行追溯
Section titled “4. 返回足够决策的信息,完整证据另行追溯”不要把完整数据库结果、日志或二进制文件全部塞给模型。列表分页,文档返回摘要与引用,大文件返回受控句柄:
{ "ok": true, "data": { "orders": [], "next_cursor": null }, "meta": { "truncated": false, "source": "orders-service", "observed_at": "2026-07-31T10:00:00Z" }}truncated 要说明是否还有未返回内容,observed_at 说明数据时间。数据库堆栈、内部 URL、密钥、Cookie 和无必要的用户内容不应进入模型上下文。
审计至少记录三组信息:
- 谁做什么:run/step ID、用户与 Agent 身份、工具版本、脱敏参数。
- 凭什么执行:权限策略版本、审批 ID、参数哈希、幂等键。
- 结果怎样:开始与结束时间、结果类别、外部 correlation ID、是否重试。
验收不只检查返回值,还要检查实际业务状态和日志。测试至少覆盖多余字段、越权 ID、重复请求、未知结果、429/5xx、审批过期、审批后参数改变、注入诱导、取消和补偿。
5. 运行位置由资源和风险决定,不由框架决定
Section titled “5. 运行位置由资源和风险决定,不由框架决定”可以用家庭助手理解部署位置:云端模型负责理解“客厅太热,开空调”,家庭服务器重新读取温度、检查设备与参数,再调用 Home Assistant。模型在云端,不妨碍设备控制和最新状态核对留在本地。
| 方案 | 适合的任务 | 主要代价 |
|---|---|---|
| 本机执行 | 个人编程、桌面自动化、私人文件 | 休眠中断、环境差异、文件和命令权限 |
| 云端服务 | 客服、知识库、固定业务接口 | 租户隔离、网络依赖、接口授权与恢复 |
| 云端沙箱 | 拉代码、跑测试、浏览器和临时文件 | 启动等待、依赖安装、计算费用、成果持久化 |
| 边缘执行 | 家电、机器人、工业网关 | 算力、硬件、升级和真实设备风险 |
| 混合部署 | 云端理解、本地或内网操作 | 跨网络的未知结果、身份传递和重复执行 |
沙箱是受限制的执行空间,可以在本机,也可以在云端。使用 Docker 不等于已经完成隔离:目录、网络、密钥、CPU、内存和执行时间都要单独限制。NIST 容器安全指南
选择顺序可以先看硬条件:
- 数据不能离开本机或内网时,执行、存储和模型请求都要符合边界,只有本地 Harness 还不够。
- 必须操作本机软件或现场设备时,保留本地工具,并在执行前后读取真实状态。
- 必须断网工作时,模型、规则、依赖和工具都需要本地可用版本。
- 会运行生成的代码时,再加沙箱;普通参数化业务接口不必每次问答都创建虚拟机。
- 中断后必须继续时,把消息、工具结果和进度放到进程之外,见状态持久化与恢复。
本地模型只在离线、数据边界或延迟确有需要时引入。量化精度、内存压力、持续发热和模型更新都要用自己的任务验证,不能仅因为工具在本地就要求模型也在本地。
6. 决策模型只负责局部选择,不负责完成整个任务
Section titled “6. 决策模型只负责局部选择,不负责完成整个任务”Jev 是 TypeSafe AI 为分类、是非判断和评分训练的决策模型。它输入业务状态和限定问题,返回选项及概率分布,适合“候选已经列好,但需要理解语言才能选择”的步骤。
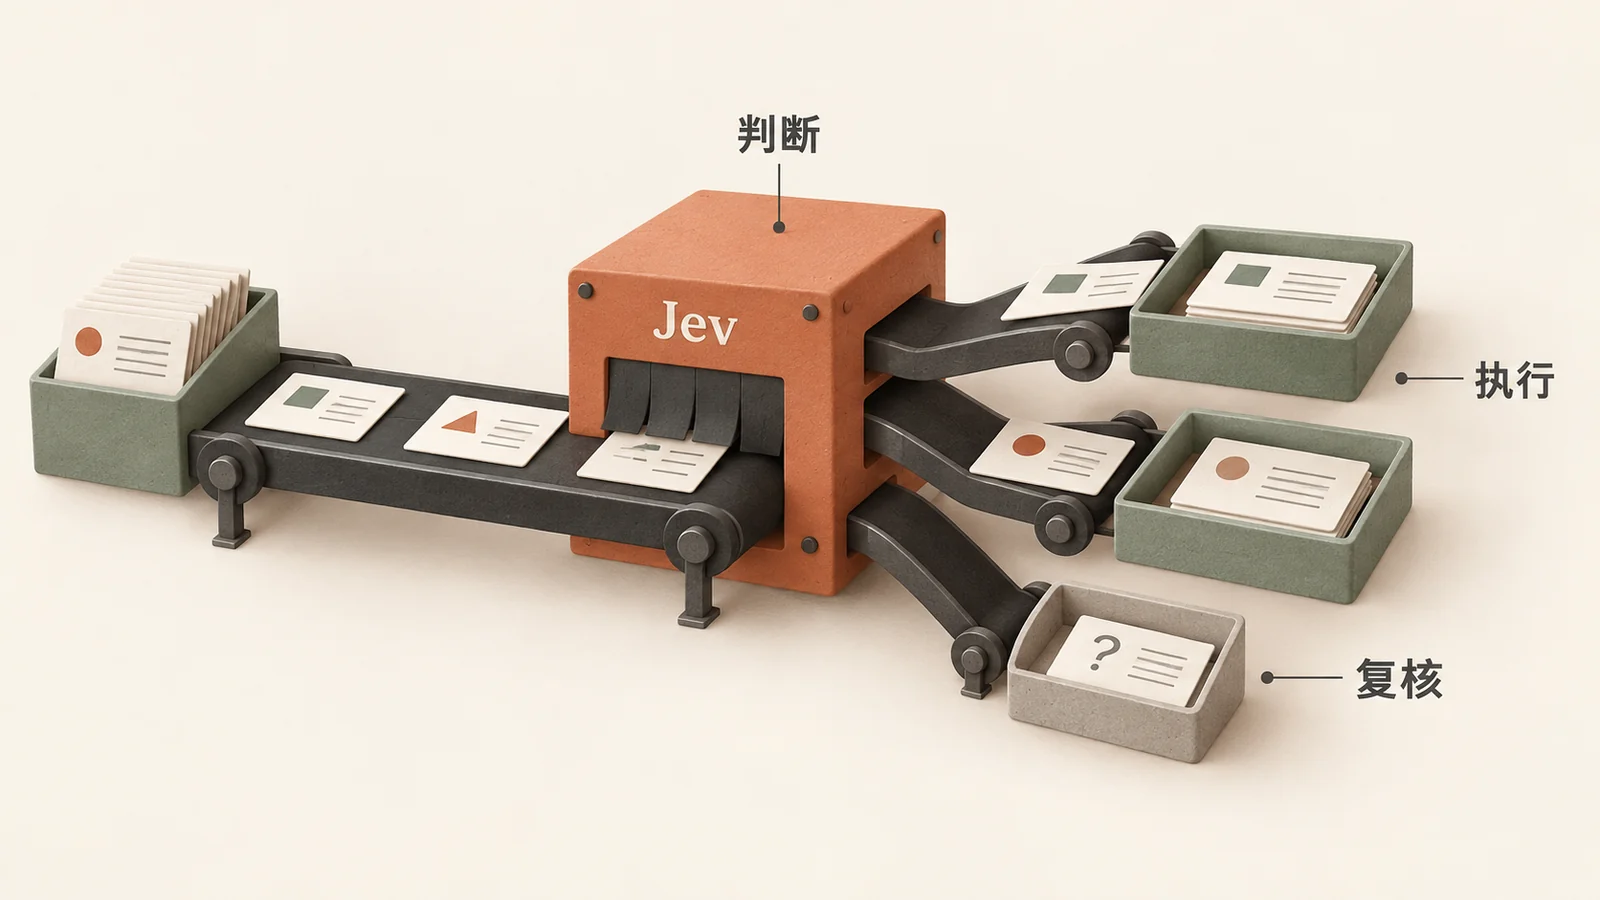
例如客服说“同一份订阅被扣了两次,请退掉重复的那笔”,可以拆成:
choice:应该交给账单、技术还是账户团队?noul:用户是否明确要求退款?score:按预设等级评估紧急程度。
模型可以辅助派单,但“用户要求退款”不证明重复扣款属实。交易记录查询、退款资格和实际退款仍由业务程序处理。
| 适合 | 不适合直接完成 |
|---|---|
| 工单分流、Agent 路由、内容筛查、候选资料相关性判断 | 写文章、生成代码、任意字段提取、精确计算、多步调查、直接决定权限或扣款 |
决策模型返回的概率需要校准:一批被预测为 90% 的判断,理想情况下约 90% 成立。它不能证明某一次判断正确,也不能替代授权和业务校验。Jev 1.13 当前只接收文本,英文是主要训练语言,中文业务必须单独评测。
API 选择按 2026-10-10 的原文核对范围:
| 服务 | 选择时要注意 |
|---|---|
阿里云百炼 decision-model-preview | System One 接口,Preview 限制与上下文缓存能力需单独确认 |
TypeSafe jev-1.13.0 / jev-latest | /v1/systemone;文本输入,调过阈值时宜固定版本 |
Vercel AI Gateway typesafe-ai/jev | 转接 TypeSafe Jev,适合已有 Gateway 的项目 |
| Cloudflare Clef / Clef-flash | Jev 之外的决策模型,支持图片输入 |
| OpenAI Decisions API | /v1/decisions,支持文本和图片,Public Beta,格式与 System One 不同 |
候选动作很多时,先用权限和设备能力排除不可用动作,再做检索或短名单复选。Jev 与百炼每个 choice 最多 255 项,但数量上限不是准确率保证。不同批次的概率不能直接比较,过早淘汰的正确动作也无法靠后续复选找回。
验证时固定一批标注样本,比较现有规则、小模型和候选 API:各类误判、自动接受结果的正确率、自动处理比例、概率校准、整体延迟和每次有效处理成本。先只记录判断,不改变原流程;确认收益后再逐步接管分流。
7. 最小落地顺序
Section titled “7. 最小落地顺序”- 先选一个只读业务工具,写清业务意图、参数、权限和结果结构。
- 加入越权、重复请求、超时和未知结果测试,再开放写操作。
- 写操作补齐幂等、审批、实际状态核对和审计。
- 根据资源位置选择本机、云端或边缘,只有执行生成代码时才引入沙箱。
- 工具超时后先查询结果,跨环境使用同一操作 ID 串起执行轨迹。
- 只有高频且候选明确的局部判断,才评估决策模型,并保留现有方案作对照。