OpenClaw 流式语音:首句延迟优化复盘
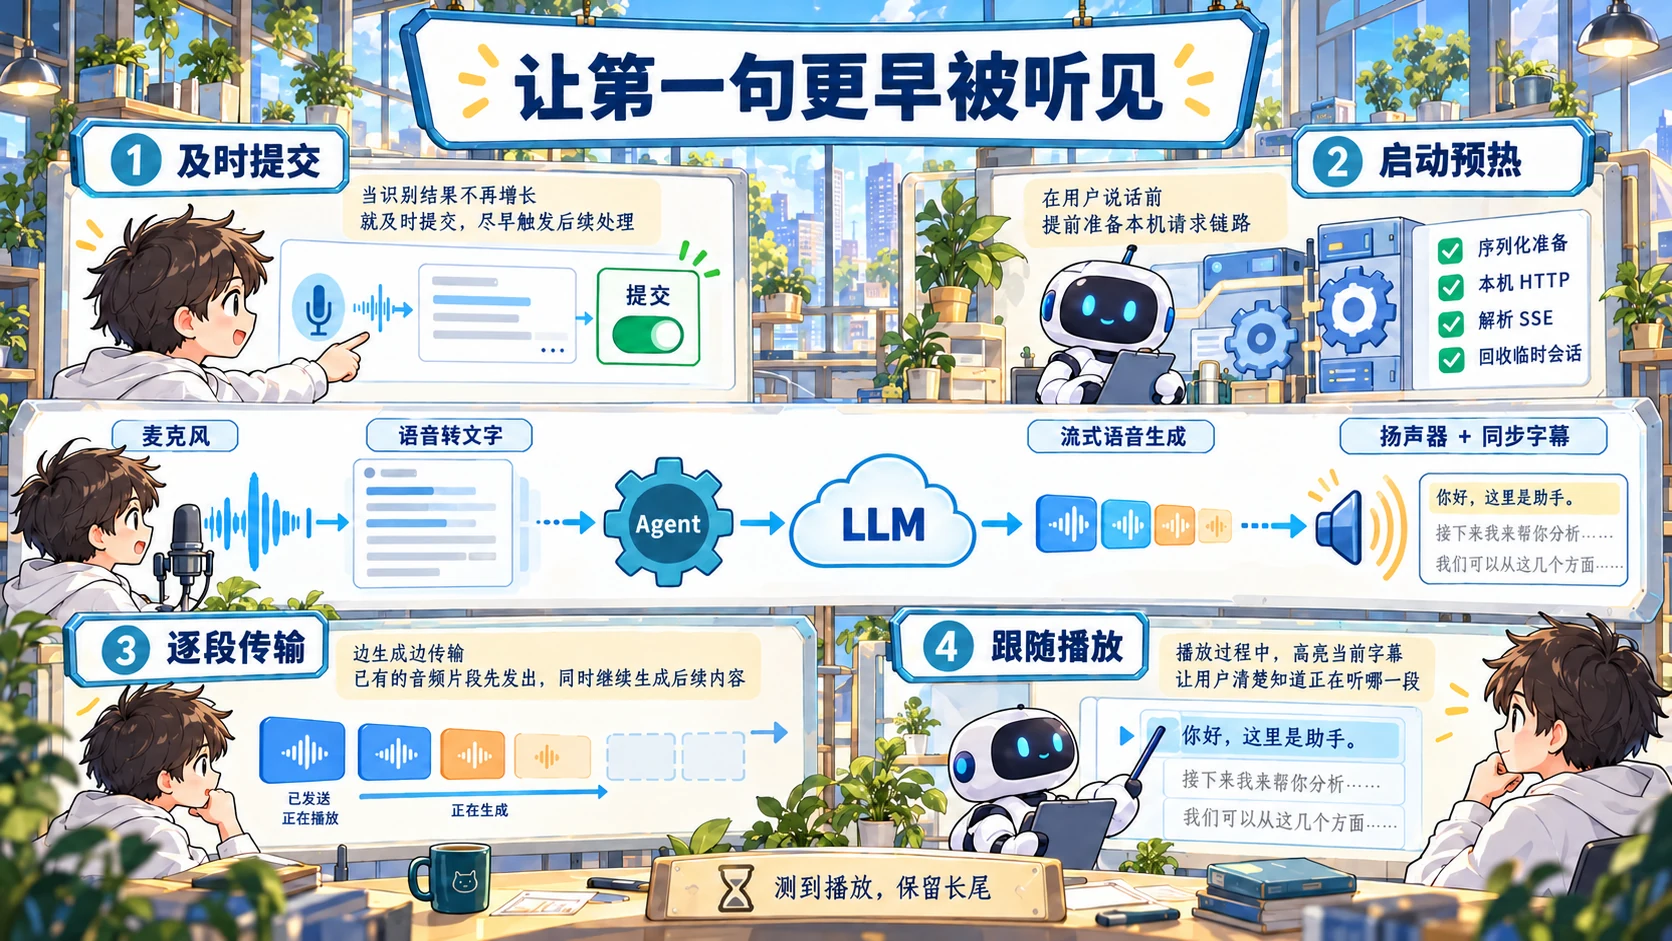
文本测试里,有几次两三秒就收到了音频。可真正对着设备说“hello hello”,反馈还是慢。我们给这个设备接入了 OpenClaw,模型和语音合成都支持流式,怎么连一句问候还要等这么久?
这次优化有两个前提:不改 OpenClaw 核心源码,也不换自定义 LLM 的调用路径。能改的是插件、后端中转和设备 UI。沿着这几层查下去,发现等待并不只发生在模型里。
七秒多,究竟花在哪了
Section titled “七秒多,究竟花在哪了”把那轮对话的日志对起来,从 UI 提交语音到播放器进入 playing,一共 7,418 ms。还没算语音活动检测(VAD)判断用户说完的时间。
链路上每一层都说自己支持流式,但协议允许逐段传,不代表中间每一跳都及时把数据交出去。这一轮里,语音识别(ASR)已经给出最终文字,系统却又等了约 3.7 秒才发出模型请求。这是整轮里最长的一段。更隐蔽的是日志里的 agent_run_start:这个回调之后,距离真正发出 HTTP 请求还有约 2,338 ms。如果从这个回调开始给模型计时,就把本机还在做的准备也算进去了。HTTP 发出时点是根据日志耗时推算的,因此图中相邻两段用了近似值。
之后的计时就不能只记“开始”和“结束”了。识别什么时候完成、请求什么时候发出、第一段文字什么时候回来、音频什么时候能播放,都要分开记。空 SSE 事件不算正文,MP3 文件头不算可播放音频,playing 只证明浏览器开始播放,声卡和扬声器要另验。MDN 对 playing 事件的定义
预热只走了一半路
Section titled “预热只走了一半路”最初的想法很直接:对话开始前那十几秒的准备,能不能挪到启动期先做掉。第一版借插件调用原有的回复分发入口,在 Agent 启动回调处取消,这样不会真的向模型发请求。隔离样本看着有效果,未预热首轮从 dispatch 到 HTTP 请求是 5,983 ms,预热后首轮降到 1,837 ms。但真实对话还是慢,说明取消点选得不对,后面的路径根本没被预热到。
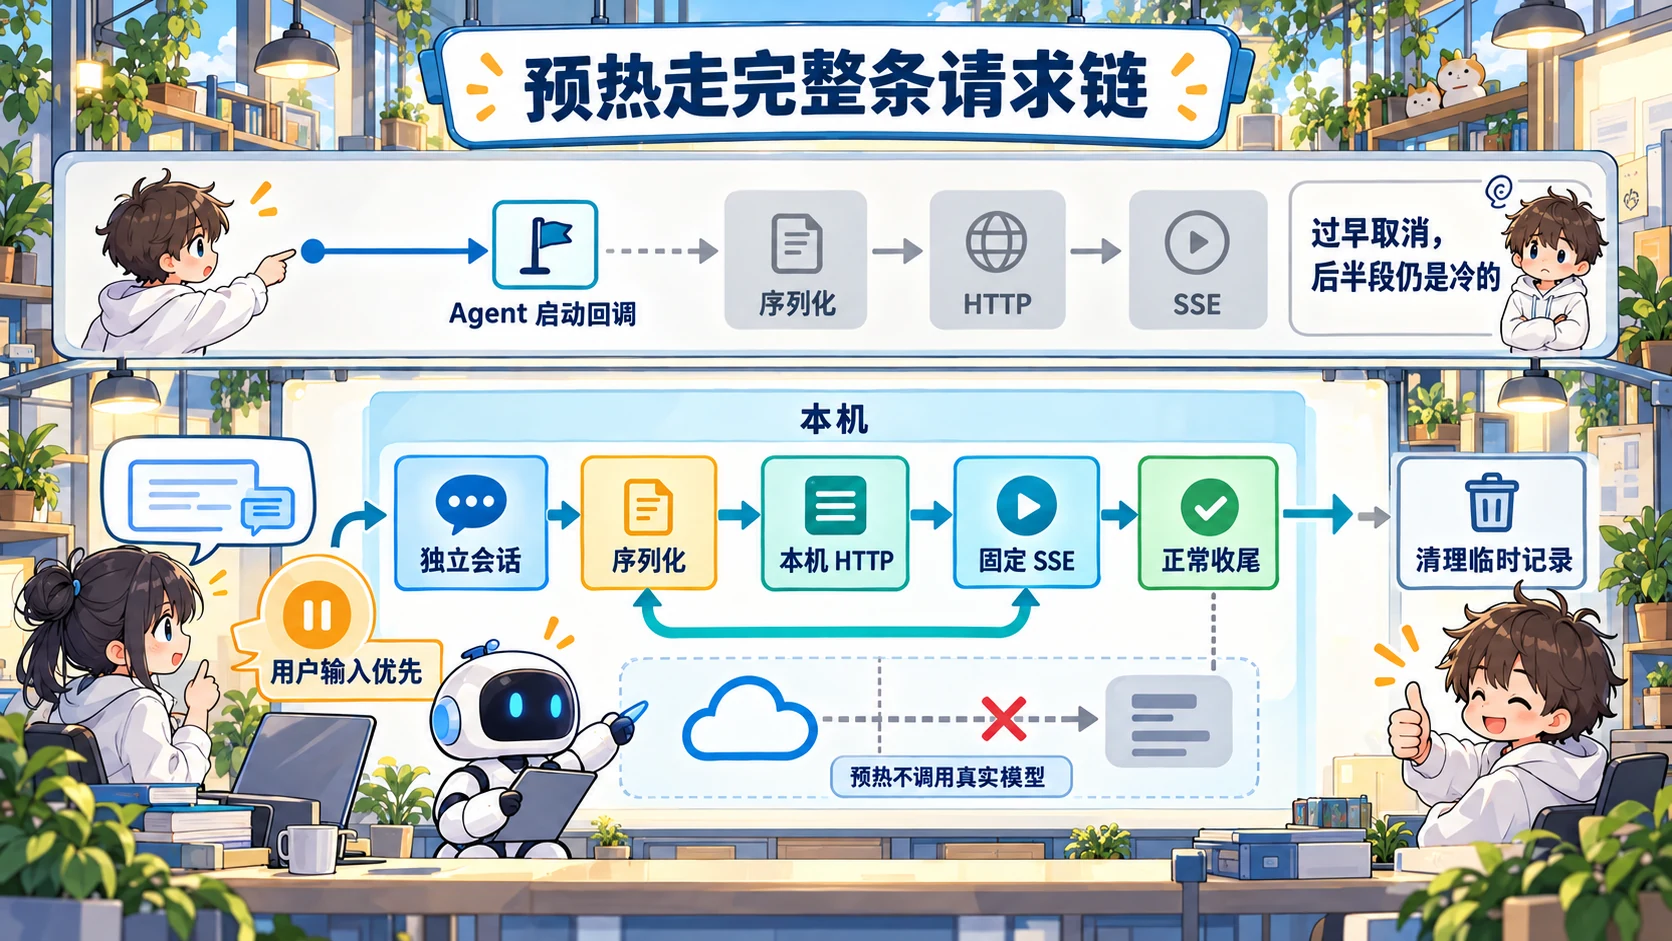
当时运行版本里的请求序列化 Worker 空闲后会退出。只把工具和上下文准备好,或者在 payload 回调里提前取消,都会漏掉后面的序列化、HTTP、SSE 解析和回复收尾。预热日志显示成功,不代表下一轮真正经过的资源还是热的。
修正版用插件的 Provider 扩展包住原生流式函数:普通请求原样交给原函数;只有本进程登记的私有预热请求,才使用克隆的调用参数,转向同进程的本机回环 HTTP 路由。这个路由返回固定 SSE,让原生处理链完整跑一遍。真实用户的模型地址、凭据和请求参数都不变,也没有给 OpenClaw 核心或全局 fetch 打补丁。预热只准备本机这条请求链,不会提前运行云端模型,真实模型请求数为零。
接着,用独立的配置和会话副本测了启动后、连续调用和空闲两分钟后的三次文本请求。计时不包含语音识别、合成和播放:
| 场景 | 输入到 HTTP 请求 | 输入到首段正文 |
|---|---|---|
| 启动预热后第一句 | 1,380 ms | 3,693 ms |
| 紧接第二句 | 1,483 ms | 3,232 ms |
| 空闲 120 秒后第一句 | 691 ms | 2,496 ms |
这组测试把 13,489 ms 的准备放到了启动时,用户主会话没有变化,临时记录清理干净,限定的工具读取测试也通过了。代价是启动变长,空闲时还要做维护。换 OpenClaw 版本或 Provider 后,需要重新验证这条路径。
预热用独立会话和一次性标记,本机路由也会校验来源、标记和请求体大小。用户一开口,它就得停下来;清理记录时也要让用户对话先写数据库。
清理这里还踩过一个坑:配了“不持久化下一条消息”,入口还是留下了临时记录,普通删除会话也没清干净相关数据,后来改用宿主的生命周期接口回收,并检查临时会话和转写记录是否归零。清理失败就停止后续预热,不能让测试记录越积越多。
数据到最后才一起过来
Section titled “数据到最后才一起过来”本机准备缩短后,还得确认数据没被中间层攒住。我们用相同模型和固定短文请求,对比公网路径与直达同一后端的诊断路径,生产模型地址保持不变。
| 路径与状态 | SSE 首包 | 首个正文 | 响应结束 |
|---|---|---|---|
| 修改前,经公网 | 3,271 ms | 3,271 ms | 3,272 ms |
| 修改前,直达后端 | 528 ms | 1,692 ms | 3,600 ms |
| 修改后,经公网 | 502 ms | 2,253 ms | 4,123 ms |
第一行里好几个块几乎挤在最后 1 ms 内一起到达。直达后端时正文是持续过来的,所以不能只看业务代码有没有逐块写出。后端给 SSE 响应加上这两个头之后,该轮公网复测恢复连续到达:
Cache-Control: no-store, no-transformX-Accel-Buffering: nono-store 和 no-transform 约束缓存存储和内容转换,X-Accel-Buffering 是否生效取决于中间层。我们没有确认入口的具体产品,也没有把不同轮模型生成的时间差全算成修复收益,所以这不是一个适用于所有网络的“关缓冲万能药”。Cache-Control 语义、SSE 服务端发送示例
TTS 建连和模型生成叠在一起
Section titled “TTS 建连和模型生成叠在一起”语音合成(TTS)这里也有一段能提前做的工作。一轮冷连接样本,从 TTS 请求到首包 2,172 ms,复用连接的一轮只要 184 ms。两轮的差额不能全归给建连,但连接本来就可以提前准备,没必要等模型给出第一句话才开始。
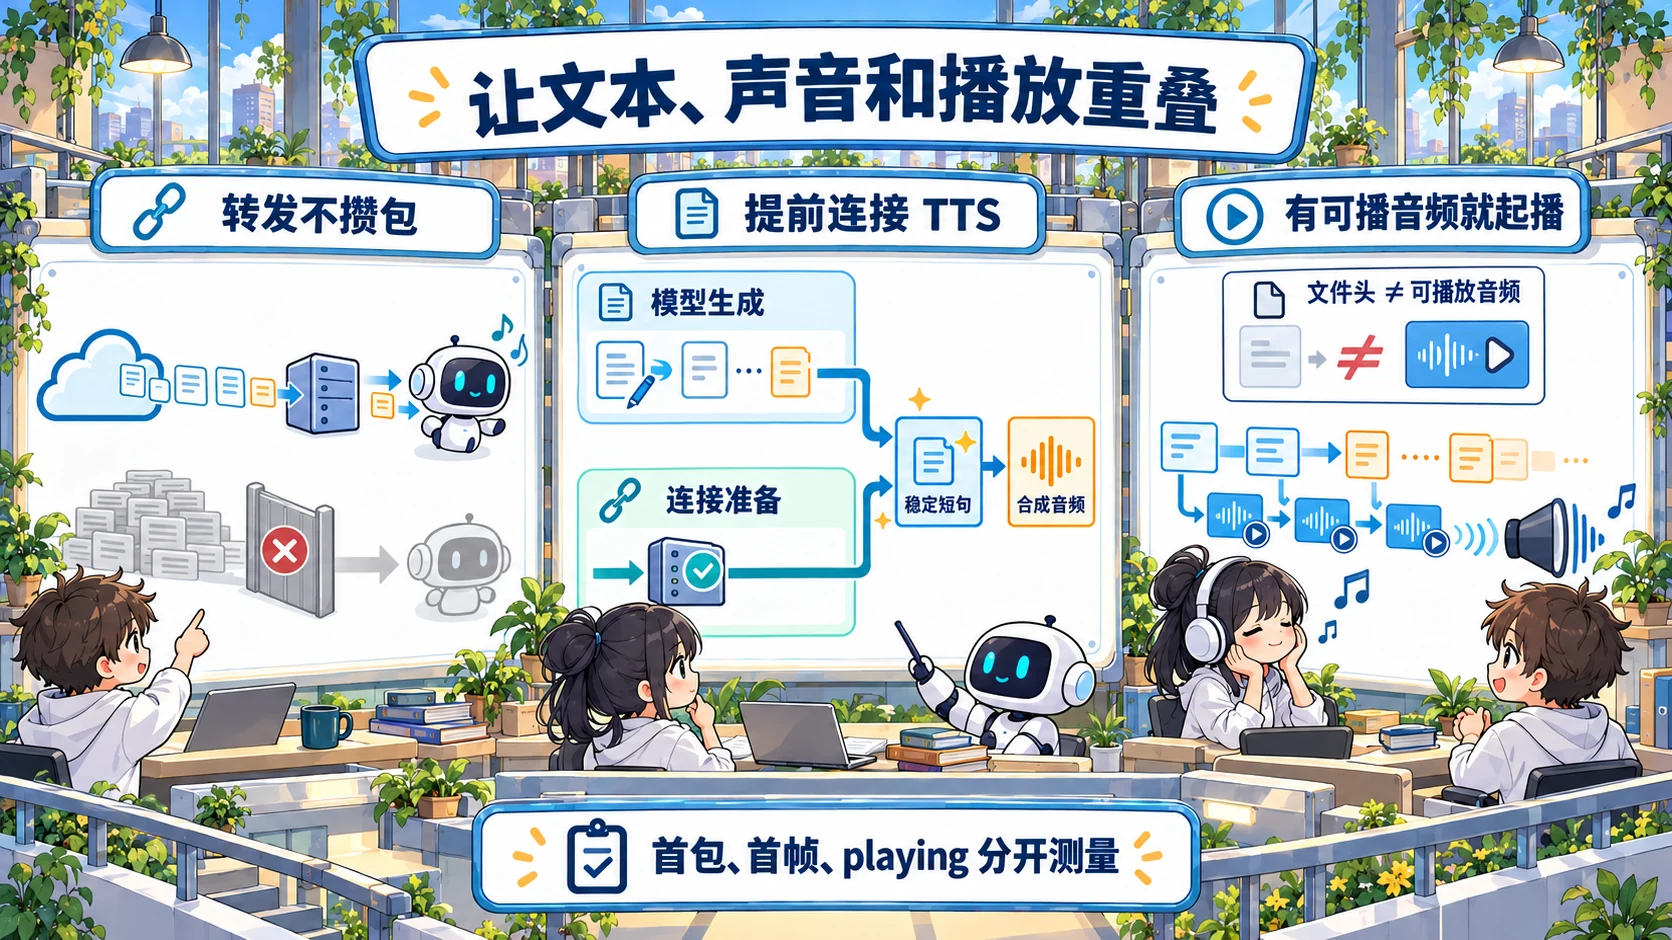
改动是在输入提交或文本派发时,就并行准备既有 TTS 中转链路的连接,让建连和模型生成重叠。准备失败不阻塞 LLM,也不为预连接发送合成文本。修改后观察到的 TTS 请求至首包约 185~309 ms;一次冷连接准备花了 1,207 ms,但在首句生成前已经完成。模型还在生成时,连接已经准备好了,首句出来后便可以直接开始合成。
模型输出按稳定短句送进 TTS,浏览器收到小音频块就追加到播放缓冲,不等整段回复生成完。但追加数据不等于能解码,实际抓到的第一包只有 44 字节,只是 MP3 文件头。所以探针继续检查完整音频帧,UI 继续记录 playing,不能用“首包很快”代替播放验证。
输入迟迟不提交,字幕却抢着跑
Section titled “输入迟迟不提交,字幕却抢着跑”输出通了,输入端还有一类拖延。现场问题是:用户说完了,环境里还有噪声,VAD 判断语音段没结束,可 ASR 文字早就不变了。VAD 判断的是声音活动,它回答不了“这句话该不该提交”。
我们加了个兜底:已有非空识别文字,连续 1 秒没有有效内容变化,就主动提交当前音频段。出现新词或改词重新计时,重复文本、空白、大小写和标点变化不延长计时。没有文字时不触发,ASR 出错时停掉这个定时器。
提交后仍然等 ASR Finalize 的最终结果,没有拿临时字幕直接当 LLM 输入。自动提交和正常 VAD 结束走同一入口,同一段只提交一次。插件完成该段收尾后返回带请求标识的确认,UI 用它隔离上一段迟到的结果;确认只表示该段处理结束,空结果或失败也可能拿到确认。
这条规则缩短的是识别停止更新之后的等待,不是承诺 1 秒内回复。识别服务卡顿、长停顿、慢速说话都可能造成过早切段,需要拿真实录音测试;旧插件没声明确认能力时,UI 保留原来的 VAD 提交方式。
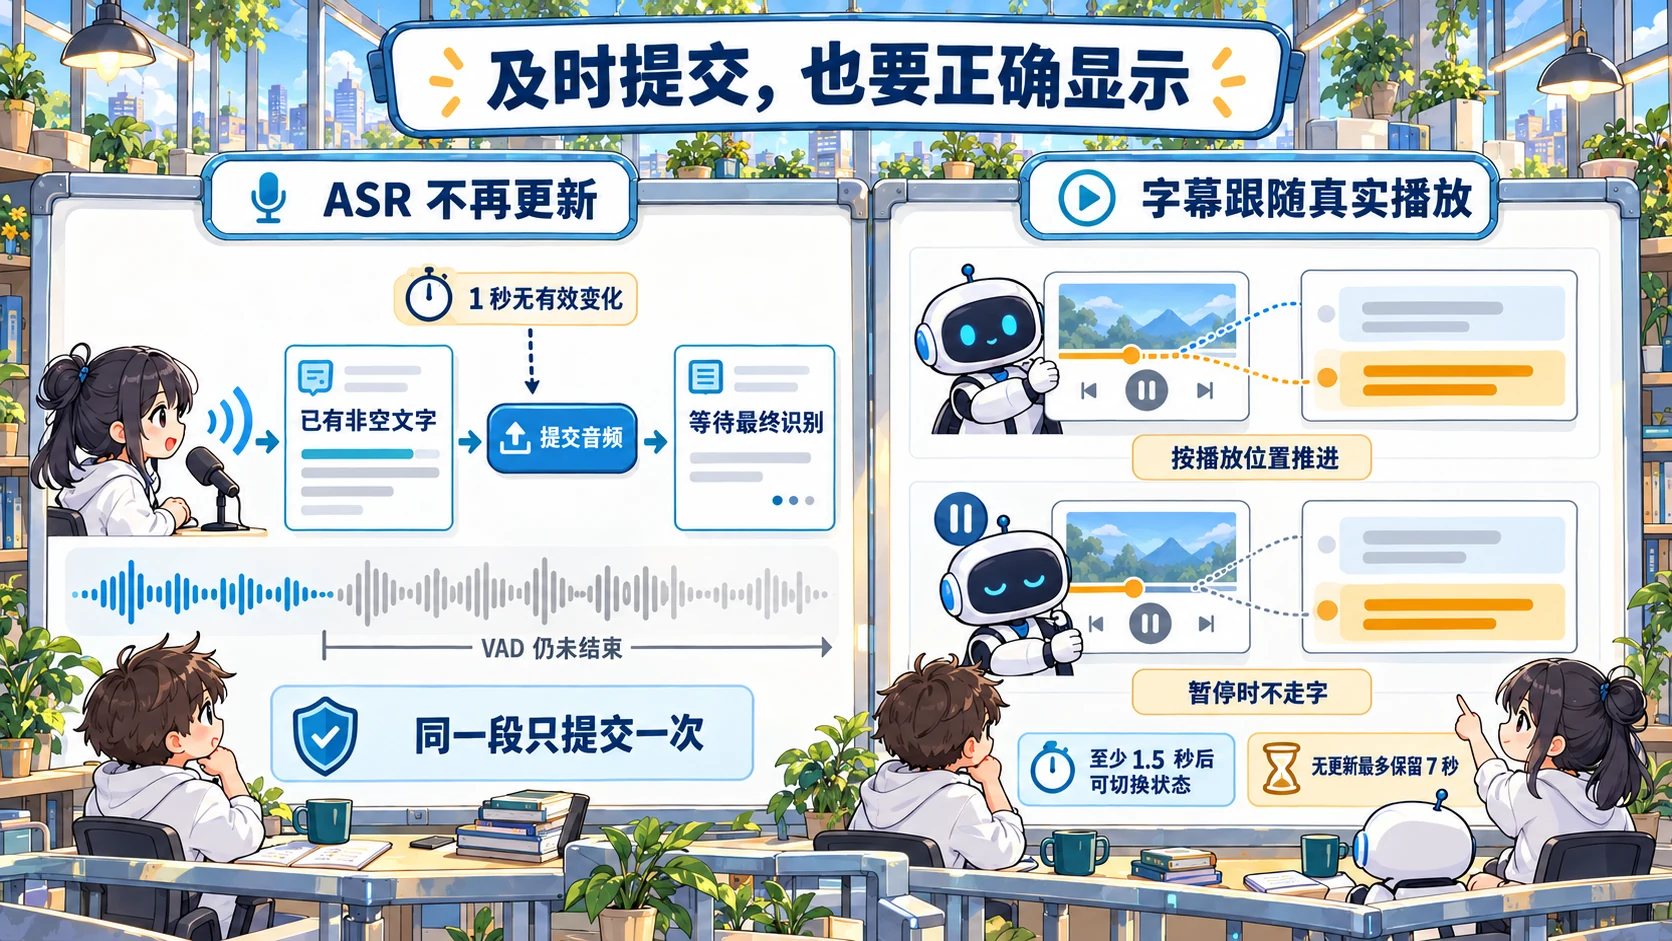
字幕这边选了一个明确的做法:回复文字和对应语音同时出现。文字属于哪段音频,由音频开始事件带过来;等对应播放器进入 playing 才展示,避免第一段播放失败后用错下一段的字幕。长回复按播放器 currentTime 推进可见窗口,保留上一行和当前行。网络缓冲把播放卡住时,字幕也停;有词级时间戳就按时间戳对齐,没有就按时长估算,不声称逐字准确。
恢复 Agent 状态显示时还要排优先级:ASR 和 AI 文字在最近一次有效更新后至少保留 1.5 秒,之后才允许 Thinking 或工具状态接替;没有更新最多保留 7 秒。新一轮真实 ASR 或回复可以直接替换旧内容,持续播放的进度会续期,长音频不会播到第 7 秒就丢字幕。状态和文字分开记录,迟到的旧状态不能盖住当前内容。
设备浏览器上的组件回放已经验证了暂停不走字和定时切换状态。这里用的是模拟事件,还需要人在设备前说话,核对实际听感。
下载抢资源和模型长尾是两回事
Section titled “下载抢资源和模型长尾是两回事”边缘设备上同时跑着角色视频、资源下载和语音。重复缓存和集中写入会拖慢前台,所以下载改成受限并发、限速和背压传输;通话时让出资源,旧视频读取不再顺带重写 Blob。目标是前台保持响应,而不只是下载更快。
旧实现一轮约 61 秒的压力试验触发了保护停止,健康检查超时 10 次;修正版隔离试验持续约 279 秒、完成 34 个文件,健康检查没有超时,最大约 116 ms。两轮工作量和时长都不同,只能说修正版在这组负载下没被拖垮,不能据此算提速倍数。后续约 383 秒的真实业务下载仍有一次超时,同期还有较长的预热数据库清理,所以也不能说资源争用已经全部消失。
设备健康也不等于回复一定快。一次下载压力期间的文本探针,客户端约 7.55 秒才收到首音频包。按时间、顺序、模型和输出长度对照后端日志,上游响应头等待 5.34 秒,鉴权、DNS、TCP、TLS 都是 0 ms,连接已复用,TTS 首包约 177 ms。同期设备健康检查正常,磁盘采样也不支持连续数秒的本地 IO 堵塞。这组关联当时没有统一的端到端 request ID,只能说明主要等待在上游响应阶段,再细分到服务端排队、推理还是返回链路,现有日志不够;继续调播放器缓冲也解决不了这段等待。
还有一类约 8 秒的样本,上游等待不足 1 秒,但请求抵达后端业务入口前就已经多花了不少时间。现有日志分不清是设备准备、传输还是入口鉴权造成的,后续也没稳定复现。这两类长尾不能混成同一个根因。
整套方案怎么落地
Section titled “整套方案怎么落地”把这些改动放在一起,一轮对话应该这样跑:设备启动时准备好本机请求链;用户说完,及时提交识别结果;模型生成期间把 TTS 连接建好;第一句稳定下来就合成、传输和播放,后面的内容继续生成。字幕跟着已经播到的位置走,下载和清理任务给对话让路。
如果从头做一遍,我会按这个顺序推进:
- 先把时间记清楚。 从用户说完测到实际起播,再拆开识别、请求前准备、模型、中转和播放。先找到最长的那段,别凭感觉改参数。
- 把已有结果尽快送出去。 检查中转是否攒包、TTS 是否在等全文、播放器是否在等全部音频。把这些等待去掉,再考虑更复杂的预热。
- 提前做可以复用的准备。 启动时准备本机请求链,模型生成时准备 TTS 连接。用户输入一来,后台准备必须让路,不能为了保持“热着”反而拖慢对话。
- 回到设备上连续用。 启动后说一句,连续说几句,放一阵再说,同时下载资源再说。还要试噪声、停顿和打断,检查有没有截断、重复提交或字幕错配。
目前,这几处明确的等待已经处理过,但首句仍有长尾,不能说已经根治。接下来要把设备和后端同一轮的请求标识串起来,继续查请求到达后端之前的空档,以及预热清理对数据库的影响。慢样本和超时都留着,积累足够样本后再看 P50、P95 和失败率。单次两三秒的结果,不能代替这些测试。
数据口径与复核资料
本文实验基于 OpenClaw 2026.10.3 和 Node 24.18.0,是该设备集成的阶段复盘,不是框架通用性能排名。原始日志包含设备与会话信息,不公开;随文提供脱敏观察数据,用于复核文中数值与图表,不能替代原始日志审计。
- 7,418 ms:真实语音 UI commit 到首次
playing,不含提交前的 VAD 等待。 - 预热表:隔离原生文本链路,终点分别为 HTTP 发出和首段正文。
- SSE 表:各路径的独立单轮请求,不能作为配对统计或 P95。
- TTS 数据:合成请求至首音频包,不等同于扬声器出声。
- 下载压力:隔离页面与真实业务分别统计,不把健康接口时延当成语音时延。
- 字幕验证:设备上的真实组件回放,尚不代表完整麦克风到扬声器验收。
机制背景可参阅本站的实时语音 Agent 工程与OpenClaw 插件边界。配图用于解释机制;数值图由脱敏数据生成。