手写 LRU Cache 为什么用哈希表加双向链表?怎样处理过期与并发?
哈希表把 key 映射到节点,双向链表维护最近使用顺序。get 命中后把节点移到头部;put 更新已有节点或插入新节点,容量超限时移除尾部最久未使用节点,并同步删除哈希表记录。哈希定位的期望成本与常数次指针操作结合,可使基础 get、put 达到期望 O(1)。
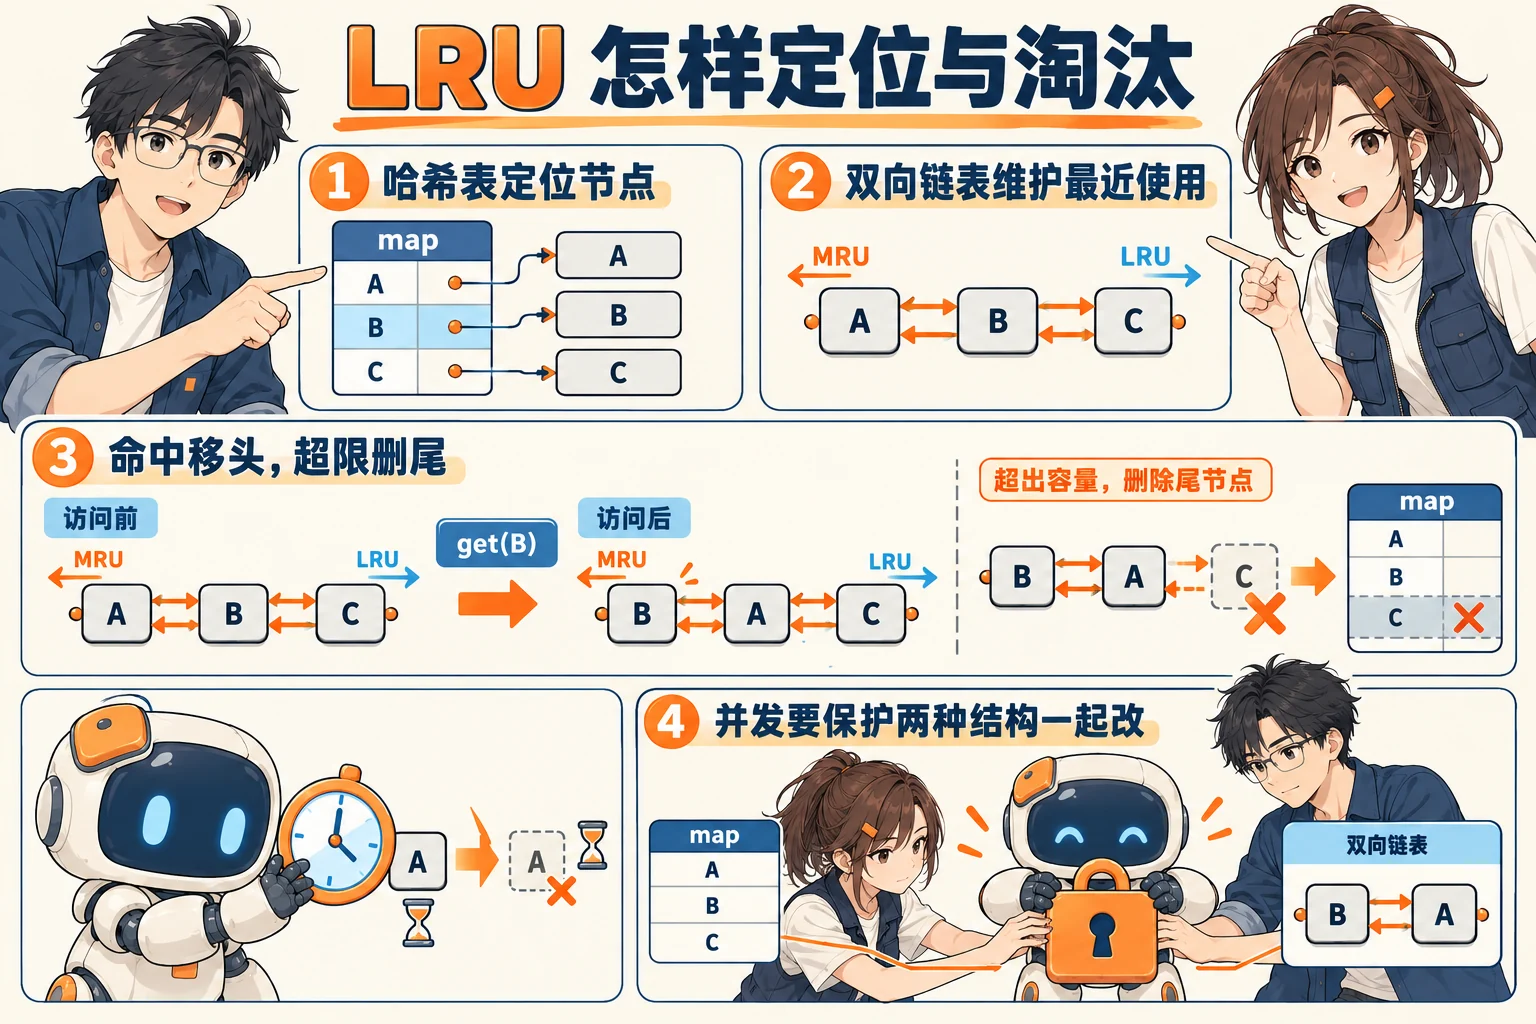
过期时间可放在节点中,访问时检查并删除;如果还要主动及时清理全部过期项,通常需要额外扫描、时间轮或堆,复杂度与语义必须重新说明,不能把增强后的所有操作仍称为 O(1)。
并发时一次访问会同时改哈希表和链表,单独换成并发 Map 还不够。可先用一把锁保护完整操作,再按性能需求分段;分段后通常也不再是全局精确 LRU。测试容量为零、重复更新、头尾移动、淘汰和过期边界。
基础单线程实现
Section titled “基础单线程实现”下面只实现容量淘汰;过期清理与并发控制需要按上面的规则补充。
class Node:    def __init__(self, key=None, value=None):        self.key, self.value = key, value        self.prev = self.next = None

class LRUCache:    def __init__(self, capacity):        if capacity < 0:            raise ValueError('capacity must be non-negative')        self.capacity, self.nodes = capacity, {}        self.head, self.tail = Node(), Node()        self.head.next, self.tail.prev = self.tail, self.head
    def _remove(self, node):        node.prev.next = node.next        node.next.prev = node.prev
    def _front(self, node):        node.prev, node.next = self.head, self.head.next        self.head.next.prev = node        self.head.next = node
    def get(self, key):        node = self.nodes.get(key)        if node is None:            return -1        self._remove(node)        self._front(node)        return node.value
    def put(self, key, value):        node = self.nodes.get(key)        if node is not None:            node.value = value            self._remove(node)        else:            node = Node(key, value)            self.nodes[key] = node        self._front(node)        if len(self.nodes) > self.capacity:            oldest = self.tail.prev            self._remove(oldest)            del self.nodes[oldest.key]
资料
核对于 2026-10-16。LeetCode LRU Cache、LinkedHashMap。工程场景与实现取舍由本站解释,不代表原帖公司的实际架构。