为 Amazon 设计分类售卖排行
注意:这个文档中的链接会直接指向系统设计主题索引中的有关部分,以避免重复的内容。你可以参考链接的相关内容,来了解其总的要点、方案的权衡取舍以及可选的替代方案。
第一步:简述用例与约束条件
Section titled “第一步:简述用例与约束条件”搜集需求与问题的范围。 提出问题来明确用例与约束条件。 讨论假设。
我们将在没有面试官明确说明问题的情况下,自己定义一些用例以及限制条件。
我们将把问题限定在仅处理以下用例的范围中
Section titled “我们将把问题限定在仅处理以下用例的范围中”- 服务根据分类计算过去一周中最受欢迎的商品
- 用户通过分类浏览过去一周中最受欢迎的商品
- 服务有着高可用性
不在用例范围内的有
Section titled “不在用例范围内的有”- 一般的电商网站
- 只为售卖排行榜设计组件
限制条件与假设
Section titled “限制条件与假设”- 网络流量不是均匀分布的
- 一个商品可能存在于多个分类中
- 商品不能够更改分类
- 不会存在如
foo/bar/baz之类的子分类 - 每小时更新一次结果
- 受欢迎的商品越多,就需要更频繁地更新
- 1000 万个商品
- 1000 个分类
- 每个月 10 亿次交易
- 每个月 1000 亿次读取请求
- 100:1 的读写比例
如果你需要进行粗略的用量计算,请向你的面试官说明。
- 每笔交易的用量:
created_at- 5 字节product_id- 8 字节category_id- 4 字节seller_id- 8 字节buyer_id- 8 字节quantity- 4 字节total_price- 5 字节- 总计:大约 40 字节
- 每个月的交易内容会产生 40 GB 的记录
- 每次交易 40 字节 * 每个月 10 亿次交易
- 3年内产生了 1.44 TB 的新交易内容记录
- 假定大多数的交易都是新交易而不是更改以前进行完的交易
- 平均每秒 400 次交易次数
- 平均每秒 40,000 次读取请求
便利换算指南:
- 每个月有 250 万秒
- 每秒一个请求 = 每个月 250 万次请求
- 每秒 40 个请求 = 每个月 1 亿次请求
- 每秒 400 个请求 = 每个月 10 亿次请求
第二步:概要设计
Section titled “第二步:概要设计”列出所有重要组件以规划概要设计。
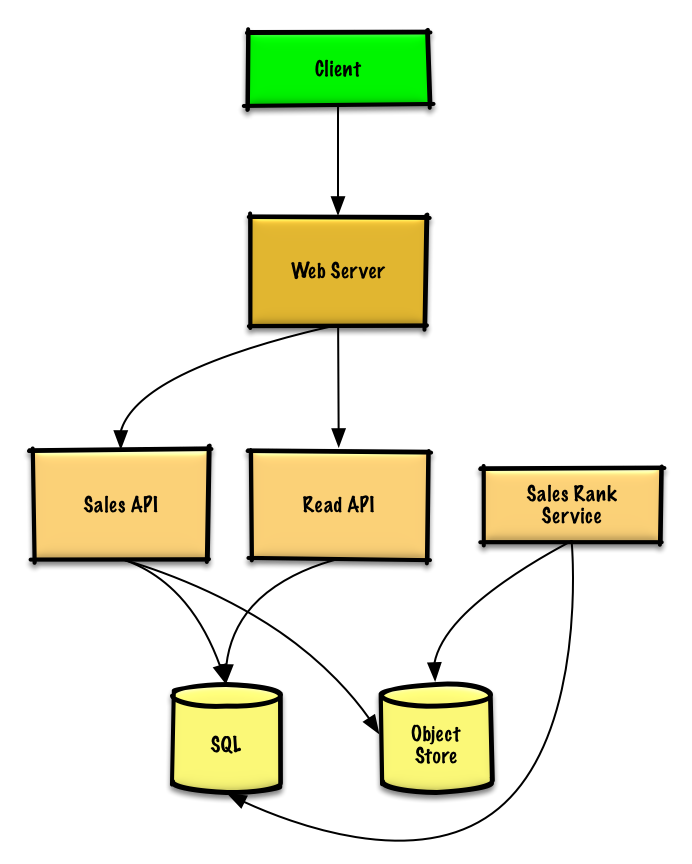
第三步:设计核心组件
Section titled “第三步:设计核心组件”深入每个核心组件的细节。
用例:服务需要根据分类计算上周最受欢迎的商品
Section titled “用例:服务需要根据分类计算上周最受欢迎的商品”我们可以在现成的对象存储系统(例如 Amazon S3 服务)中存储 售卖 API 服务产生的日志文本, 因此不需要我们自己搭建分布式文件系统了。
向你的面试官告知你准备写多少代码。
假设下面是一个用 tab 分割的简易的日志记录:
timestamp product_id category_id qty total_price seller_id buyer_idt1 product1 category1 2 20.00 1 1t2 product1 category2 2 20.00 2 2t2 product1 category2 1 10.00 2 3t3 product2 category1 3 7.00 3 4t4 product3 category2 7 2.00 4 5t5 product4 category1 1 5.00 5 6...售卖排行服务 需要用到 MapReduce,并使用 售卖 API 服务进行日志记录,同时将结果写入 SQL 数据库中的总表 sales_rank 中。我们也可以讨论一下究竟是用 SQL 还是用 NoSQL。
我们需要通过以下步骤使用 MapReduce:
- 第 1 步 - 将数据转换为
(category, product_id), sum(quantity)的形式 - 第 2 步 - 执行分布式排序
class SalesRanker(MRJob):
    def within_past_week(self, timestamp):        """如果时间戳属于过去的一周则返回 True,        否则返回 False。"""        ...
    def mapper(self, _ line):        """解析日志的每一行,提取并转换相关行,
        将键值对设定为如下形式:
        (category1, product1), 2        (category2, product1), 2        (category2, product1), 1        (category1, product2), 3        (category2, product3), 7        (category1, product4), 1        """        timestamp, product_id, category_id, quantity, total_price, seller_id, \            buyer_id = line.split('\t')        if self.within_past_week(timestamp):            yield (category_id, product_id), quantity
    def reducer(self, key, value):        """将每个 key 的值加起来。
        (category1, product1), 2        (category2, product1), 3        (category1, product2), 3        (category2, product3), 7        (category1, product4), 1        """        yield key, sum(values)
    def mapper_sort(self, key, value):        """构造 key 以确保正确的排序。
        将键值对转换成如下形式:
        (category1, 2), product1        (category2, 3), product1        (category1, 3), product2        (category2, 7), product3        (category1, 1), product4
        MapReduce 的 shuffle/sort 步骤会对键进行        分布式排序,得到如下结果:
        (category1, 1), product4        (category1, 2), product1        (category1, 3), product2        (category2, 3), product1        (category2, 7), product3        """        category_id, product_id = key        quantity = value        yield (category_id, quantity), product_id
    def reducer_identity(self, key, value):        yield key, value
    def steps(self):        """ 此处为 map reduce 步骤"""        return [            self.mr(mapper=self.mapper,                    reducer=self.reducer),            self.mr(mapper=self.mapper_sort,                    reducer=self.reducer_identity),        ]
得到的结果将会是如下的排序列,我们将其插入 sales_rank 表中:
(category1, 1), product4(category1, 2), product1(category1, 3), product2(category2, 3), product1(category2, 7), product3sales_rank 表的数据结构如下:
id int NOT NULL AUTO_INCREMENTcategory_id int NOT NULLtotal_sold int NOT NULLproduct_id int NOT NULLPRIMARY KEY(id)FOREIGN KEY(category_id) REFERENCES Categories(id)FOREIGN KEY(product_id) REFERENCES Products(id)我们会以 id、category_id 与 product_id 创建一个 索引以加快查询速度(只需要使用读取日志的时间,不再需要每次都扫描整个数据表)并让数据常驻内存。从内存读取 1 MB 连续数据大约要花 250 微秒,而从 SSD 读取同样大小的数据要花费 4 倍的时间,从机械硬盘读取需要花费 80 倍以上的时间。1
用例:用户需要根据分类浏览上周中最受欢迎的商品
Section titled “用例:用户需要根据分类浏览上周中最受欢迎的商品”- 客户端向运行反向代理的 Web 服务器发送一个请求
- 这个 Web 服务器将请求转发给查询 API 服务
- The 查询 API 服务将从 SQL 数据库的
sales_rank表中读取数据
我们可以调用一个公共的 REST API:
$ curl https://amazon.com/api/v1/popular?category_id=1234返回:
{ "id": "100", "category_id": "1234", "total_sold": "100000", "product_id": "50",},{ "id": "53", "category_id": "1234", "total_sold": "90000", "product_id": "200",},{ "id": "75", "category_id": "1234", "total_sold": "80000", "product_id": "3",},而对于服务器内部的通信,我们可以使用 RPC。
第四步:架构扩展
Section titled “第四步:架构扩展”根据限制条件,找到并解决瓶颈。
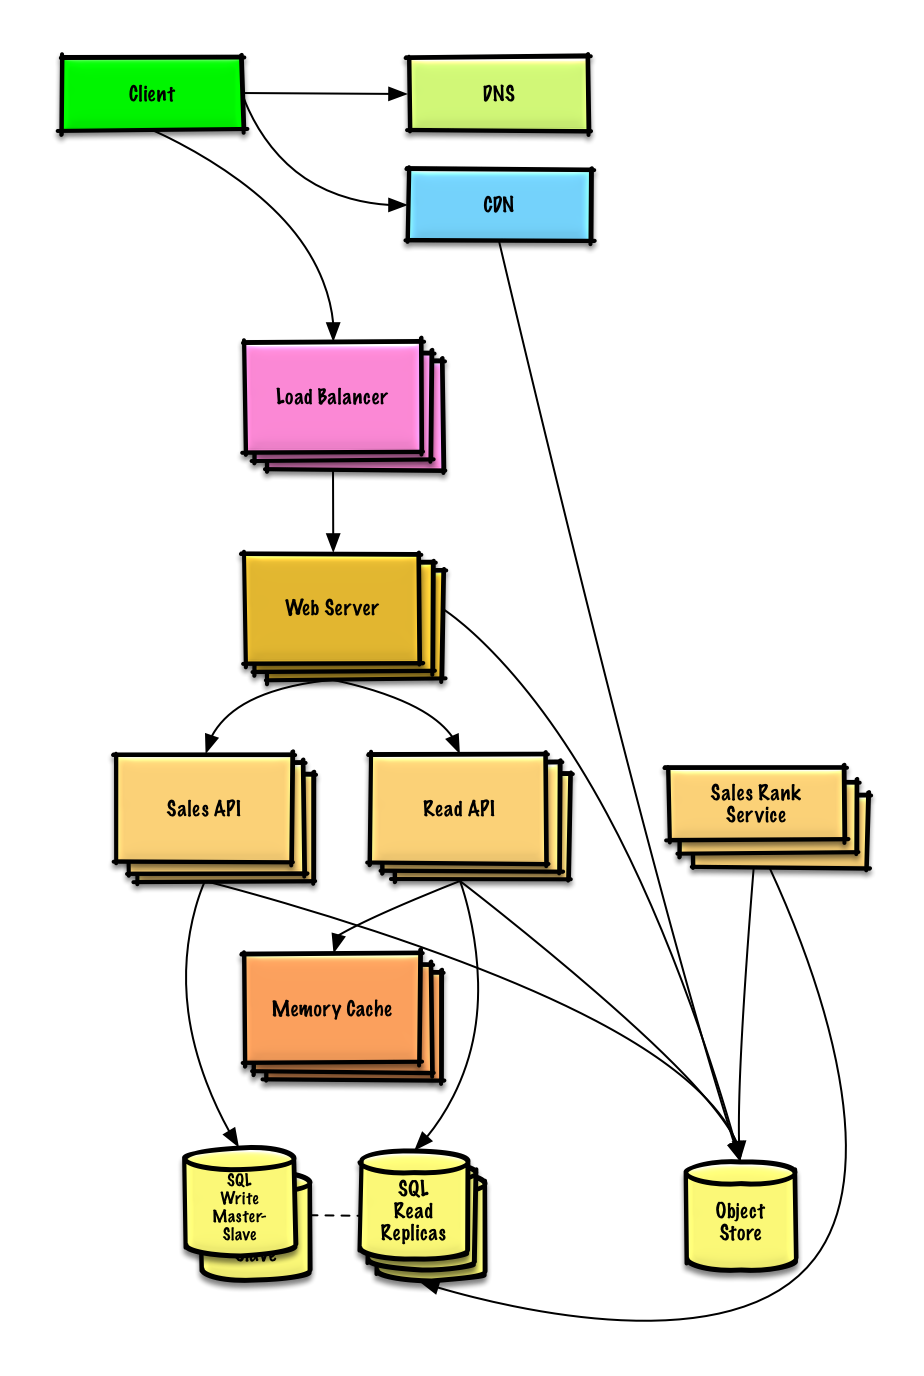
重要提示:不要从最初设计直接跳到最终设计中!
现在你要 1) 基准测试、负载测试。2) 分析、描述性能瓶颈。3) 在解决瓶颈问题的同时,评估替代方案、权衡利弊。4) 重复以上步骤。请阅读「设计一个系统,并将其扩大到为数以百万计的 AWS 用户服务」 来了解如何逐步扩大初始设计。
讨论初始设计可能遇到的瓶颈及相关解决方案是很重要的。例如加上一个配置多台 Web 服务器的负载均衡器是否能够解决问题?CDN呢?主从复制呢?它们各自的替代方案和需要权衡的利弊又有什么呢?
我们将会介绍一些组件来完成设计,并解决架构扩张问题。内置的负载均衡器将不做讨论以节省篇幅。
为了避免重复讨论,请参考系统设计主题索引相关部分来了解其要点、方案的权衡取舍以及可选的替代方案。
分析数据库 可以用现成的数据仓储系统,例如使用 Amazon Redshift 或者 Google BigQuery 的解决方案。
当使用数据仓储技术或者对象存储系统时,我们只想在数据库中存储有限时间段的数据。Amazon S3 的对象存储系统可以很方便地设置每个月限制只允许新增 40 GB 的存储内容。
平均每秒 40,000 次的读取请求(峰值将会更高), 可以通过扩展 内存缓存 来处理热点内容的读取流量,这对于处理不均匀分布的流量和流量峰值也很有用。由于读取量非常大,SQL Read 副本 可能会遇到处理缓存未命中的问题,我们可能需要使用额外的 SQL 扩展模式。
平均每秒 400 次写操作(峰值将会更高)可能对于单个 SQL 写主-从 模式来说比较很困难,因此同时还需要更多的扩展技术
SQL 缩放模式包括:
我们也可以考虑将一些数据移至 NoSQL 数据库。
是否深入这些额外的主题,取决于你的问题范围和剩下的时间。
异步与微服务
Section titled “异步与微服务”- 可权衡选择的方案:
- 与客户端的外部通信 - 使用 REST 作为 HTTP API
- 服务器内部通信 - RPC
- 服务发现
请参阅「安全」一章。
请参阅「每个程序员都应该知道的延迟数」。
- 持续进行基准测试并监控你的系统,以解决他们提出的瓶颈问题。
- 架构拓展是一个迭代的过程。