为社交网络设计数据结构
注释:为了避免重复,这篇文章的链接直接关联到 系统设计主题 的相关章节。为一讨论要点、折中方案和可选方案做参考。
第 1 步:用例和约束概要
Section titled “第 1 步:用例和约束概要”收集需求并调查问题。 通过提问清晰用例和约束。 讨论假设。
如果没有面试官提出明确的问题,我们将自己定义一些用例和约束条件。
我们就处理以下用例审视这一问题
Section titled “我们就处理以下用例审视这一问题”- 用户 寻找某人并显示与被寻人之间的最短路径
- 服务 高可用
- 流量分布不均
- 某些搜索比别的更热门,同时某些搜索仅执行一次
- 图数据不适用单一机器
- 图的边没有权重
- 1 千万用户
- 每个用户平均有 50 个朋友
- 每月 10 亿次朋友搜索
训练使用更传统的系统 - 别用图特有的解决方案例如 GraphQL 或图数据库如 Neo4j。
向你的面试官厘清你是否应该做粗略的使用计算
- 50 亿朋友关系
- 1 亿用户 * 平均每人 50 个朋友
- 每秒 400 次搜索请求
便捷的转换指南:
- 每月 250 万秒
- 每秒 1 个请求 = 每月 250 万次请求
- 每秒 40 个请求 = 每月 1 亿次请求
- 每秒 400 个请求 = 每月 10 亿次请求
第 2 步:创建高级设计方案
Section titled “第 2 步:创建高级设计方案”用所有重要组件概述高水平设计
第 3 步:设计核心组件
Section titled “第 3 步:设计核心组件”深入每个核心组件的细节。
用例: 用户搜索某人并查看到被搜人的最短路径
Section titled “用例: 用户搜索某人并查看到被搜人的最短路径”和你的面试官说清你期望的代码量
没有百万用户(点)的和十亿朋友关系(边)的限制,我们能够用一般 BFS 方法解决无权重最短路径任务:
class Graph(Graph):
    def shortest_path(self, source, dest):        if source is None or dest is None:            return None        if source is dest:            return [source.key]        prev_node_keys = self._shortest_path(source, dest)        if prev_node_keys is None:            return None        else:            path_ids = [dest.key]            prev_node_key = prev_node_keys[dest.key]            while prev_node_key is not None:                path_ids.append(prev_node_key)                prev_node_key = prev_node_keys[prev_node_key]            return path_ids[::-1]
    def _shortest_path(self, source, dest):        queue = deque()        queue.append(source)        prev_node_keys = {source.key: None}        source.visit_state = State.visited        while queue:            node = queue.popleft()            if node is dest:                return prev_node_keys            prev_node = node            for adj_node in node.adj_nodes.values():                if adj_node.visit_state == State.unvisited:                    queue.append(adj_node)                    prev_node_keys[adj_node.key] = prev_node.key                    adj_node.visit_state = State.visited        return None
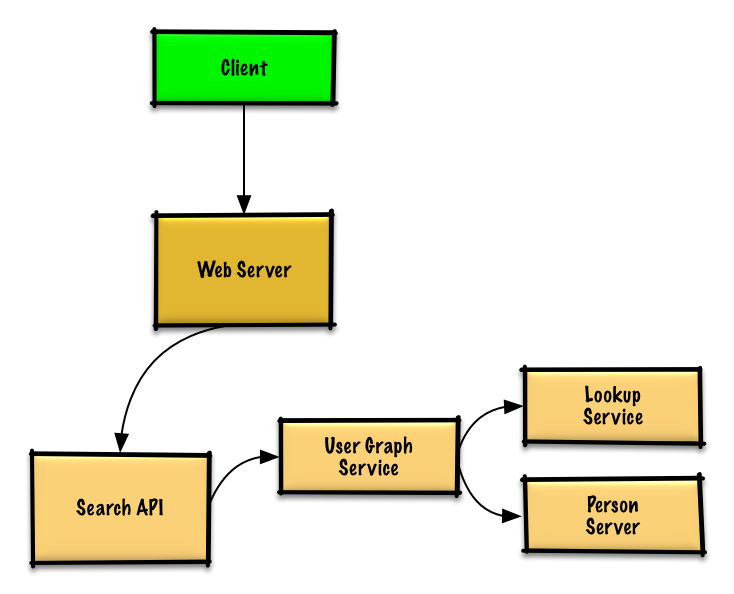
我们不能在同一台机器上满足所有用户,我们需要通过 人员服务器 拆分 用户并且通过 查询服务 访问。
- 客户端 向 服务器 发送请求,服务器 作为 反向代理
- Web 服务器 将请求转发给 搜索 API 服务器
- 搜索 API 服务器向 用户图服务 转发请求
- 用户图服务 有以下功能:
- 使用 查询服务 找到当前用户信息存储的 人员服务器
- 找到适当的 人员服务器 检索当前用户的
friend_ids列表 - 把当前用户作为
source运行 BFS 搜索算法同时 当前用户的friend_ids作为每个adjacent_node的 ids - 给定 id 获取
adjacent_node:- 用户图服务 将 再次 和 查询服务 通讯,最后判断出和给定 id 相匹配的存储
adjacent_node的 人员服务器(有待优化)
- 用户图服务 将 再次 和 查询服务 通讯,最后判断出和给定 id 相匹配的存储
和你的面试官说清你应该写的代码量
说明:为简化示例,以下代码省略了错误处理。请向面试官确认是否需要补充。
查询服务 实现:
class LookupService(object):
    def __init__(self):        self.lookup = self._init_lookup()  # key: person_id, value: person_server
    def _init_lookup(self):        ...
    def lookup_person_server(self, person_id):        return self.lookup[person_id]
人员服务器 实现:
class PersonServer(object):
    def __init__(self):        self.people = {}  # key: person_id, value: person
    def add_person(self, person):        ...
    def people(self, ids):        results = []        for id in ids:            if id in self.people:                results.append(self.people[id])        return results
用户 实现:
class Person(object):
    def __init__(self, id, name, friend_ids):        self.id = id        self.name = name        self.friend_ids = friend_ids
用户图服务 实现:
class UserGraphService(object):
    def __init__(self, lookup_service):        self.lookup_service = lookup_service
    def person(self, person_id):        person_server = self.lookup_service.lookup_person_server(person_id)        return person_server.people([person_id])
    def shortest_path(self, source_key, dest_key):        if source_key is None or dest_key is None:            return None        if source_key is dest_key:            return [source_key]        prev_node_keys = self._shortest_path(source_key, dest_key)        if prev_node_keys is None:            return None        else:            # Iterate through the path_ids backwards, starting at dest_key            path_ids = [dest_key]            prev_node_key = prev_node_keys[dest_key]            while prev_node_key is not None:                path_ids.append(prev_node_key)                prev_node_key = prev_node_keys[prev_node_key]            # Reverse the list since we iterated backwards            return path_ids[::-1]
    def _shortest_path(self, source_key, dest_key, path):        # Use the id to get the Person        source = self.person(source_key)        # Update our bfs queue        queue = deque()        queue.append(source)        # prev_node_keys keeps track of each hop from        # the source_key to the dest_key        prev_node_keys = {source_key: None}        # We'll use visited_ids to keep track of which nodes we've        # visited, which can be different from a typical bfs where        # this can be stored in the node itself        visited_ids = set()        visited_ids.add(source.id)        while queue:            node = queue.popleft()            if node.key is dest_key:                return prev_node_keys            prev_node = node            for friend_id in node.friend_ids:                if friend_id not in visited_ids:                    friend_node = self.person(friend_id)                    queue.append(friend_node)                    prev_node_keys[friend_id] = prev_node.key                    visited_ids.add(friend_id)        return None
我们用的是公共的 REST API:
$ curl https://social.com/api/v1/friend_search?person_id=1234响应:
{ "person_id": "100", "name": "foo", "link": "https://social.com/foo",},{ "person_id": "53", "name": "bar", "link": "https://social.com/bar",},{ "person_id": "1234", "name": "baz", "link": "https://social.com/baz",},内部通信使用 远端过程调用。
第 4 步:扩展设计
Section titled “第 4 步:扩展设计”在给定约束条件下,定义和确认瓶颈。
重要:别简化从最初设计到最终设计的过程!
你将要做的是:1) 基准/负载 测试, 2) 瓶颈 概述, 3) 当评估可选和折中方案时定位瓶颈,4) 重复。以 在 AWS 上设计支持百万级到千万级用户的系统 为参考迭代地扩展最初设计。
讨论最初设计可能遇到的瓶颈和处理方法十分重要。例如,什么问题可以通过添加多台 Web 服务器 作为 负载均衡 解决?CDN?主从副本?每个问题都有哪些替代和 折中 方案?
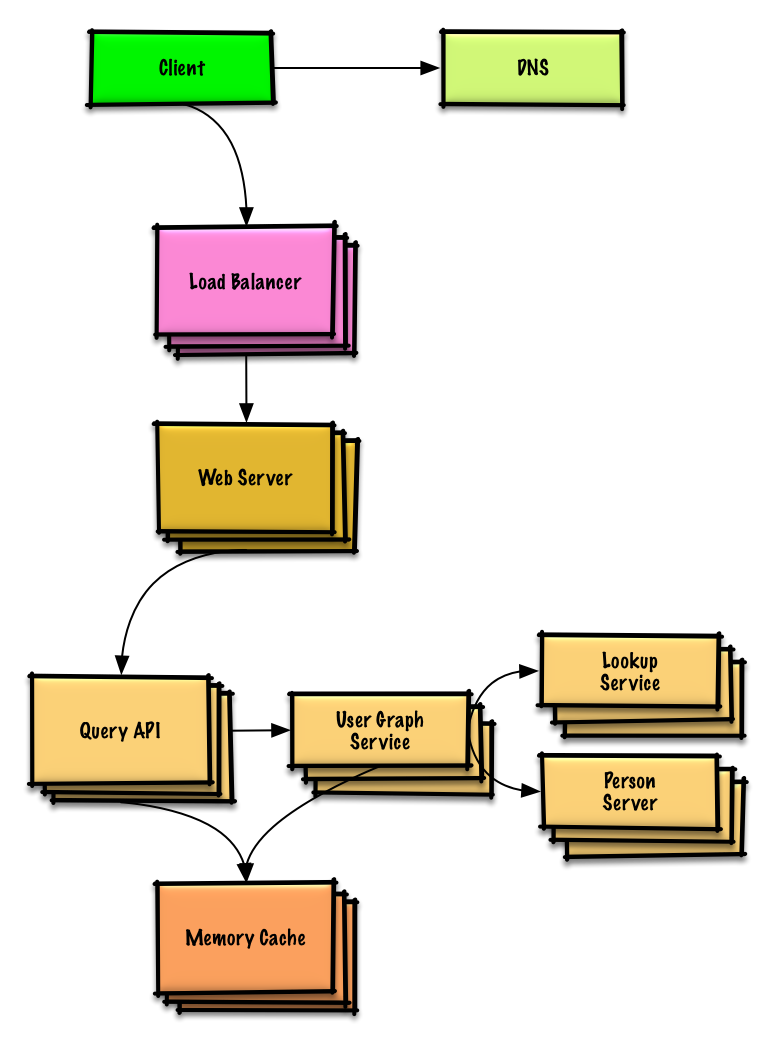
我们即将介绍一些组件来完成设计和解决扩展性问题。内部负载均衡不显示以减少混乱。
避免重复讨论,以下网址链接到 系统设计主题 相关的主流方案、折中方案和替代方案。
解决 平均 每秒 400 次请求的限制(峰值),人员数据可以存在例如 Redis 或 Memcached 这样的 内存 中以减少响应次数和下游流量通信服务。这尤其在用户执行多次连续查询和查询哪些广泛连接的人时十分有用。从内存中读取 1MB 数据大约要 250 微秒,从 SSD 中读取同样大小的数据时间要长 4 倍,从硬盘要长 80 倍。1
以下是进一步优化方案:
- 在 内存 中存储完整的或部分的BFS遍历加快后续查找
- 在 NoSQL 数据库 中批量离线计算并存储完整的或部分的BFS遍历加快后续查找
- 在同一台 人员服务器 上托管批处理同一批朋友查找减少机器跳转
- 通过地理位置 拆分 人员服务器 来进一步优化,因为朋友通常住得都比较近
- 同时进行两个 BFS 查找,一个从 source 开始,一个从 destination 开始,然后合并两个路径
- 从有庞大朋友圈的人开始找起,这样更有可能减小当前用户和搜索目标之间的 离散度数
- 在询问用户是否继续查询之前设置基于时间或跳跃数阈值,当在某些案例中搜索耗费时间过长时。
- 使用类似 Neo4j 的 图数据库 或图特定查询语法,例如 GraphQL(如果没有禁止使用 图数据库 的限制的话)
根据问题的范围和剩余时间,还需要深入讨论其他问题。
SQL 扩展模式
Section titled “SQL 扩展模式”异步性和微服务
Section titled “异步性和微服务”- 关于折中方案的讨论:
- 客户端的外部通讯 - 遵循 REST 的 HTTP APIs
- 内部通讯 - RPC
- 服务探索
参考 安全章节
延迟数字指标
Section titled “延迟数字指标”查阅 每个程序员必懂的延迟数字
- 继续基准测试并监控你的系统以解决出现的瓶颈问题
- 扩展是一个迭代的过程